Apache-Kafka-Tutorial: Kafka mit KRaft unter Ubuntu 24.04 installieren

Apache Kafka ist eine leistungsfähige Plattform für die Verarbeitung kontinuierlicher Datenströme. Die Open-Source-Software kommt zum Einsatz, wenn Anwendungen große Mengen an Ereignissen in Echtzeit austauschen, speichern und verarbeiten sollen.
Was ist Apache Kafka?
Apache Kafka ist eine verteilte Event-Streaming-Plattform. Anwendungen können mit Kafka kontinuierlich Daten bzw. sogenannte Events erzeugen, speichern, übertragen und verarbeiten. Ein Event kann beispielsweise eine Bestellung in einem Onlineshop, eine Statusänderung in einer Anwendung, ein Sensormesswert oder eine Zahlung sein.
Kafka organisiert diese Daten in sogenannten Topics. Ein Topic lässt sich vereinfacht mit einem Kanal vergleichen, in den Anwendungen Daten schreiben und aus dem andere Anwendungen diese Daten wieder auslesen können.
Dabei spielen insbesondere drei Komponenten eine Rolle:
- Ein Producer erzeugt Events und schreibt sie in ein Kafka-Topic.
- Ein Broker ist ein Kafka-Server, der die Events speichert und bereitstellt.
- Ein Consumer liest und verarbeitet Events aus einem Topic.
Topics lassen sich zusätzlich in mehrere Partitionen unterteilen. Dadurch können große Datenmengen auf mehrere Broker verteilt und parallel verarbeitet werden. Mehrere Kafka-Server bilden gemeinsam einen Kafka-Cluster. Kafka wird deshalb unter anderem für Event-driven Architectures, Log- und Monitoring-Pipelines, Microservices, Datenintegration und Echtzeitanalysen eingesetzt.
- NEU: Flexibel skalieren mit VM-Cloning, Load Balancing, neuen Storage-Optionen und mehr
- Unbegrenzt Traffic, > 99,99% Verfügbarkeit
- 24/7 Experten-Support mit persönlichem Berater
Kafka KRaft vs. ZooKeeper
Bei älteren Kafka-Versionen war Apache ZooKeeper ein wichtiger Bestandteil der Architektur. ZooKeeper verwaltete unter anderem Informationen über Broker, Topics, Partitionen und weitere Cluster-Metadaten. In modernen Kafka-Versionen übernimmt Kafka diese Aufgabe selbst. Dafür kommt KRaft, das auf dem Raft-Konsensverfahren basiert, zum Einsatz. Bestimmte Kafka-Nodes übernehmen dabei die Rolle von Controllern und verwalten die Metadaten des Clusters.
Kafka kennt im KRaft-Modus drei mögliche Rollen:
broker: Der Server speichert und verarbeitet die eigentlichen Kafka-Daten.controller: Der Server verwaltet die Metadaten des Clusters.broker,controller: Der Server übernimmt beide Aufgaben.
Für Entwicklungs-, Test- und Lernumgebungen können Broker und Controller auf demselben Server betrieben werden. Für kritische Produktivumgebungen empfiehlt Apache hingegen, die Rollen voneinander zu trennen.
Möchten Sie Kafka ohne ZooKeeper installieren, benötigen Sie mit Kafka 4.x keine zusätzliche ZooKeeper-Installation und keinen ZooKeeper-Service mehr. Bestehende ältere Kafka-Cluster im ZooKeeper-Modus müssen dagegen zunächst zu KRaft migriert werden, bevor ein Upgrade auf Kafka 4.x möglich ist. Kafka 3.9 war die letzte Versionsreihe, die den ZooKeeper-Modus unterstützte.
Voraussetzungen für die Kafka-Installation
Für dieses Apache-Kafka-Tutorial sind folgende Voraussetzungen erforderlich:
- Ubuntu 24.04 LTS
- Apache Kafka 4.3.1
- OpenJDK 21
- User-Konto mit
sudo-Rechten - SSH-Zugang zum Server
- mindestens einige Gigabyte freien Speicherplatz
Neben Ubuntu 24.04 LTS ist mit Ubuntu 26.04 LTS eine neuere LTS-Version verfügbar. Dieses Tutorial verwendet Ubuntu 24.04 LTS, das weiterhin unterstützt wird und sich für die Installation von Apache Kafka eignet. Die beschriebenen grundlegenden Installationsschritte lassen sich auch unter Ubuntu 26.04 durchführen.
Apache Kafka 4.3 unterstützt Java 17, Java 21 und Java 25 vollständig. Für diese Anleitung verwenden wir OpenJDK 21, das unter Ubuntu 24.04 direkt über die offiziellen Paketquellen installiert werden kann.
Für eine reine Lern- oder Testumgebung benötigen Sie keinen Server mit mehreren Dutzend Gigabyte Arbeitsspeicher. Ein kleiner VPS oder Cloud Server mit beispielsweise 2 vCPUs und 4 GB RAM reicht für das Single-Node-Setup dieses Kafka-Tutorials grundsätzlich aus. Bei lediglich 2 GB RAM steht weniger Spielraum für Java, Kafka und das Betriebssystem zur Verfügung, weshalb 4 GB komfortabler sind.
Für produktive Kafka-Systeme gelten andere Anforderungen. Dort hängen benötigte CPU-, RAM- und Speicherressourcen unter anderem von Nachrichtendurchsatz, Anzahl der Partitionen, Replikationsfaktor, Aufbewahrungsdauer und Anzahl der Clients ab.
- Kostengünstige vCPUs und leistungsstarke dedizierte Cores
- Höchste Flexibilität ohne Mindestvertragslaufzeit
- Inklusive 24/7 Experten-Support
Kafka auf einem IONOS VPS oder Cloud Server installieren
Für das Kafka-Tutorial können Sie beispielsweise einen IONOS VPS oder Cloud Server verwenden. Erstellen Sie zunächst im IONOS Cloud Panel einen Server mit Ubuntu 24.04 und verbinden Sie sich anschließend per SSH mit diesem. Für das Tutorial greifen Producer und Consumer ausschließlich lokal auf Kafka zu. Der Kafka-Port 9092 muss daher nicht öffentlich über die Server-Firewall erreichbar sein.
Schritt 1: Java-Laufzeitumgebung installieren
Aktualisieren Sie zunächst die Paketinformationen Ihres Ubuntu-Systems:
sudo apt updateAnschließend installieren Sie OpenJDK 21 sowie wget, das wir später für den Kafka-Download benötigen:
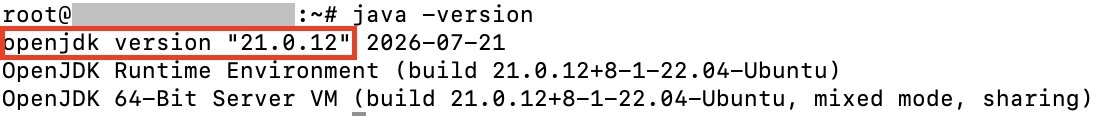
sudo apt install -y openjdk-21-jdk wgetOb Java erfolgreich installiert wurde, überprüfen Sie mit:
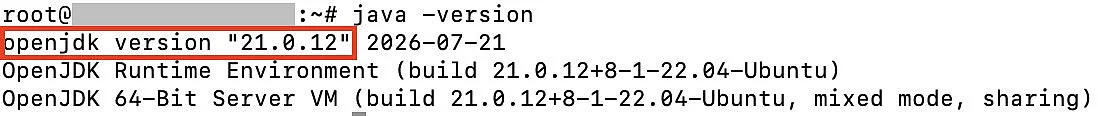
java -versionDie Ausgabe sollte OpenJDK 21 anzeigen.
Schritt 2: User für Kafka erstellen
Kafka sollte nicht dauerhaft mit Root-Rechten ausgeführt werden. Erstellen Sie deshalb einen eigenen Systembenutzer und eine zugehörige Gruppe:
sudo groupadd --system kafka
sudo useradd --system \
    --gid kafka \
    --home-dir /opt/kafka \
    --shell /usr/sbin/nologin \
kafkaDer User kafka erhält bewusst keine normale Login-Shell. Er wird später ausschließlich verwendet, um den Kafka-Service auszuführen.
Legen Sie anschließend die Verzeichnisse für die Kafka-Installation und die gespeicherten Kafka-Daten an:
sudo mkdir -p /opt/kafka
sudo mkdir -p /var/lib/kafkaSchritt 3: Apache Kafka herunterladen und installieren
Apache Kafka wird als komprimiertes Archiv bereitgestellt. In unserem Apache-Kafka-Tutorial verwenden wir Kafka 4.3.1 mit Scala 2.13. Die Versionsnummer 2.13 innerhalb des Dateinamens bezeichnet dabei die verwendete Scala-Binärversion; die eigentliche Kafka-Version ist 4.3.1.
Wechseln Sie zunächst in das temporäre Verzeichnis:
cd /tmpLaden Sie anschließend das Kafka-Archiv direkt von Apache herunter:
wget https://downloads.apache.org/kafka/4.3.1/kafka_2.13-4.3.1.tgzEntpacken Sie das Archiv nach /opt/kafka:
sudo tar -xzf kafka_2.13-4.3.1.tgz \
    -C /opt/kafka \
--strip-components=1Durch --strip-components=1 werden die Kafka-Dateien direkt unter /opt/kafka abgelegt und nicht in einem zusätzlichen Unterverzeichnis.
Übertragen Sie anschließend die Besitzrechte auf den zuvor angelegten Kafka-User:
sudo chown -R kafka:kafka /opt/kafka
sudo chown -R kafka:kafka /var/lib/kafkaMit folgendem Befehl können Sie sich den Inhalt des Installationsverzeichnisses anzeigen lassen:
ls /opt/kafkaSie sollten unter anderem die Verzeichnisse bin, config und libs sehen.


Schritt 4: Kafka für KRaft konfigurieren
Kafka 4.3.1 enthält bereits eine für KRaft vorgesehene Datei unter:
/opt/kafka/config/server.propertiesÖffnen Sie die Datei:
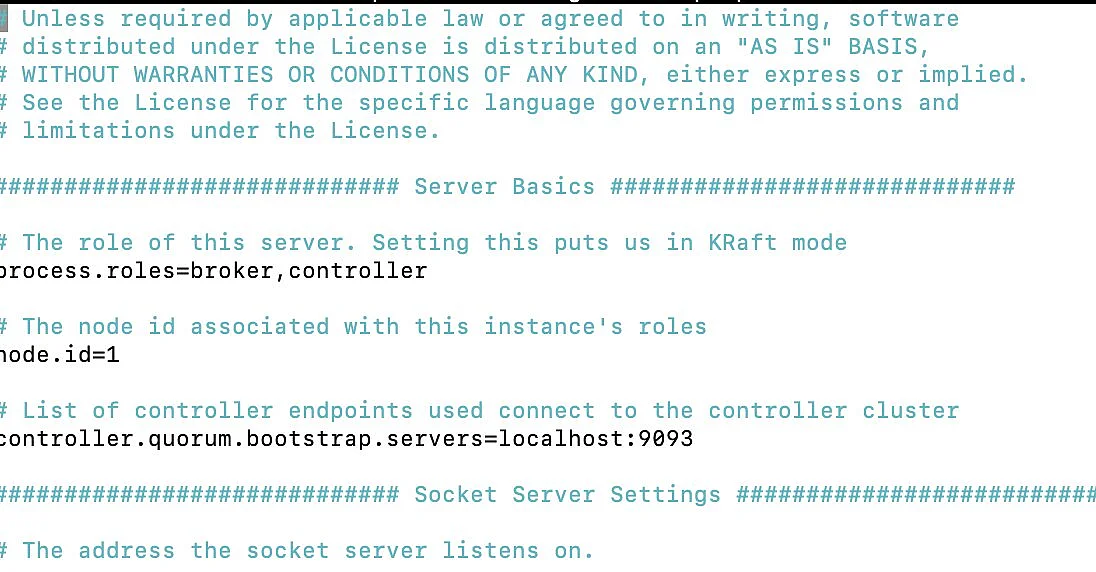
sudo nano /opt/kafka/config/server.propertiesFür unser Single-Node-Tutorial übernimmt derselbe Kafka-Prozess sowohl die Broker- als auch die Controller-Rolle. Kontrollieren bzw. ändern Sie die folgenden Werte:
process.roles=broker,controller
node.id=1
controller.quorum.bootstrap.servers=127.0.0.1:9093
controller.listener.names=CONTROLLER
listeners=PLAINTEXT://127.0.0.1:9092,CONTROLLER://127.0.0.1:9093
advertised.listeners=PLAINTEXT://127.0.0.1:9092
inter.broker.listener.name=PLAINTEXT
listener.security.protocol.map=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
log.dirs=/var/lib/kafka
offsets.topic.replication.factor=1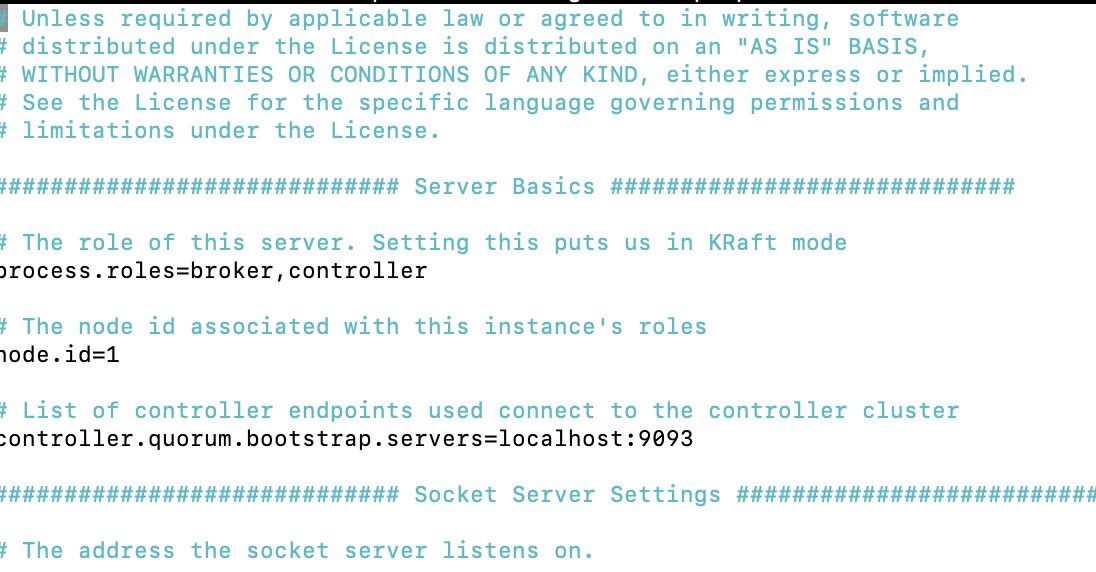
Die wichtigsten Einstellungen haben folgende Bedeutung:
process.roles=broker,controllerlegt fest, dass dieser Kafka-Server sowohl Broker als auch Controller ist. Diese kombinierte Betriebsart eignet sich besonders für Entwicklungs- und Testumgebungen.node.id=1weist dem Kafka-Node eine eindeutige Kennung zu. In einem Cluster muss jeder Node eine eigene ID besitzen.controller.quorum.bootstrap.serversgibt an, über welche Adresse Kafka den KRaft-Controller erreichen kann. Da Broker und Controller in unserem Beispiel auf demselben Server laufen, verwenden wir Port9093auf der lokalen Adresse.- Der Eintrag
listenerslegt fest, auf welchen Adressen Kafka Verbindungen annimmt. Port9092wird für die Kommunikation mit Kafka-Clients verwendet, Port9093für den Controller. - Mit
advertised.listenersteilt Kafka Clients mit, unter welcher Adresse der Broker erreichbar ist. log.dirs=/var/lib/kafkadefiniert das Verzeichnis, in dem Kafka seine Daten speichert. Die mit Kafka gelieferte Beispielkonfiguration verwendet standardmäßig ein Verzeichnis unter/tmp. Für einen dauerhaft als Service laufenden Kafka-Server ist ein eigenes Datenverzeichnis wie/var/lib/kafkazweckmäßiger.offsets.topic.replication.factor=1setzt den Replikationsfaktor des internen Offset-Topics passend zum Single-Broker-Setup auf 1.
Die Listener sind in diesem Tutorial bewusst an 127.0.0.1 gebunden. Dadurch können ausschließlich Anwendungen auf demselben Server Kafka erreichen. Öffnen Sie Port 9092 nicht einfach für das öffentliche Internet.
Schritt 5: KRaft-Cluster initialisieren
Bevor Kafka zum ersten Mal gestartet werden kann, muss der KRaft-Speicher formatiert werden. Hierbei handelt es sich um einen Initialisierungsschritt, der bei einem bereits eingerichteten Kafka-Server nicht bei jedem Start erneut ausgeführt wird.
Zunächst erzeugen Sie eine eindeutige Cluster-ID:
KAFKA_CLUSTER_ID=$(/opt/kafka/bin/kafka-storage.sh random-uuid)Mit echo "$KAFKA_CLUSTER_ID" können Sie sich die erzeugte ID anzeigen lassen.

Anschließend formatieren Sie die Kafka-Datenverzeichnisse:
sudo -u kafka /opt/kafka/bin/kafka-storage.sh format \
    --standalone \
    -t "$KAFKA_CLUSTER_ID" \
-c /opt/kafka/config/server.propertiesMit --standalone wird ein neues KRaft-Controller-Quorum mit diesem Node als zunächst einzigem Mitglied angelegt. Dieses Verfahren entspricht dem aktuellen Kafka-KRaft-Modell mit dynamischem Controller-Quorum. Die Cluster-ID verbindet die Datenverzeichnisse mit dem Kafka-Cluster. Beim Einrichten eines Clusters mit mehreren Servern muss deshalb für alle Nodes desselben Clusters dieselbe Cluster-ID verwendet werden.
Schritt 6: systemd-Service für Kafka erstellen
Bis hierhin könnten Sie Kafka manuell über kafka-server-start.sh starten. Auf einem Server ist es jedoch praktischer, Kafka als regulären Linux-Dienst über systemd auszuführen.
Erstellen Sie dafür eine neue Service-Datei:
sudo nano /etc/systemd/system/kafka.serviceFügen Sie folgenden Inhalt ein:
[Unit]
Description=Apache Kafka Server (KRaft)
After=network.target
[Service]
Type=simple
User=kafka
Group=kafka
Environment="KAFKA_HEAP_OPTS=-Xms1G -Xmx1G"
ExecStart=/opt/kafka/bin/kafka-server-start.sh /opt/kafka/config/server.properties
Restart=on-failure
RestartSec=5
[Install]
WantedBy=multi-user.targetSpeichern und schließen Sie die Datei anschließend.
Schritt 7: Kafka starten
Damit systemd die neue Service-Datei erkennt, laden Sie zunächst die Konfiguration neu:
sudo systemctl daemon-reloadAktivieren Sie Kafka anschließend für den automatischen Start beim Hochfahren des Servers und starten Sie den Dienst direkt:
sudo systemctl enable --now kafkaÜberprüfen Sie den Status:
sudo systemctl status kafka --no-pagerIst Kafka erfolgreich gestartet, sollte der Service als active (running) angezeigt werden.
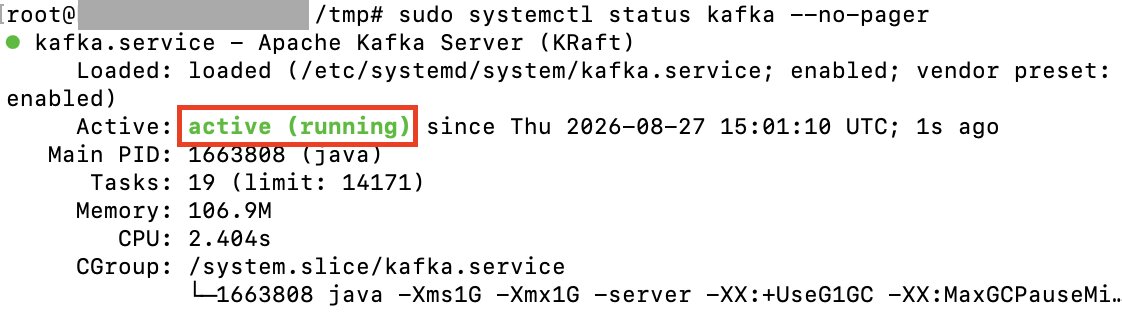
Falls Kafka nicht startet, können Sie die letzten Logmeldungen mit folgendem Befehl abrufen:
sudo journalctl -u kafka -n 50 --no-pagerSchritt 8: Erstes Kafka-Topic erstellen
Nun läuft Ihr erster Kafka-Server. Im nächsten Schritt testen wir, ob sich Daten tatsächlich schreiben und wieder auslesen lassen. Kafka speichert Events in Topics. Erstellen Sie ein Topic mit dem Namen tutorial-topic:
/opt/kafka/bin/kafka-topics.sh \
    --create \
    --topic tutorial-topic \
    --bootstrap-server localhost:9092 \
    --partitions 1 \
    --replication-factor 1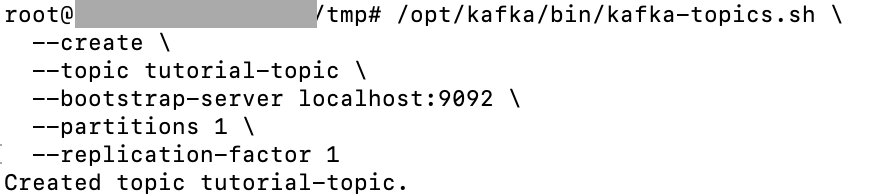
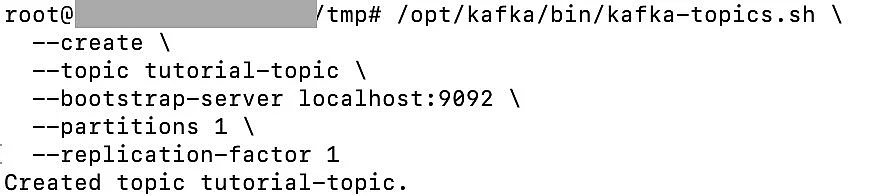
Da unser Test-Cluster nur aus einem Broker besteht, verwenden wir einen Replikationsfaktor von 1.
Kafka 4.x verwendet für administrative Befehle --bootstrap-server.
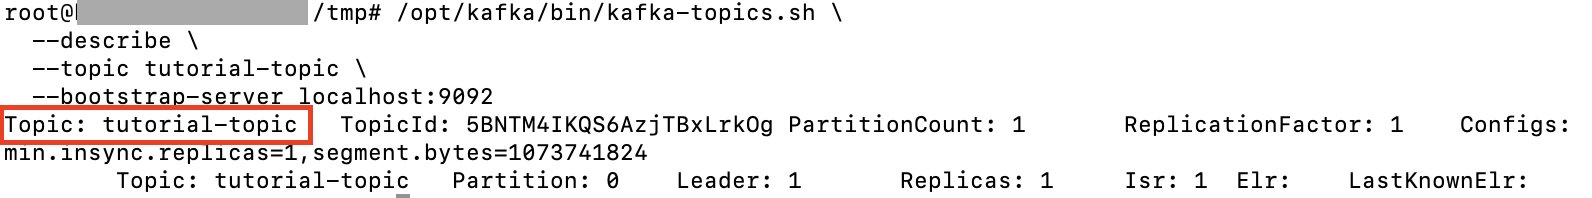
Ob das Topic korrekt angelegt wurde, überprüfen Sie mit:
/opt/kafka/bin/kafka-topics.sh \
    --describe \
    --topic tutorial-topic \
--bootstrap-server localhost:9092Die Ausgabe enthält unter anderem den Namen des Topics sowie Informationen zur Partition und Replikation.
Schritt 9: Kafka-Producer testen
Nun benötigen Sie einen Producer, der Nachrichten in das Topic schreibt. Starten Sie den mit Kafka gelieferten Console Producer:
/opt/kafka/bin/kafka-console-producer.sh \
    --topic tutorial-topic \
--bootstrap-server localhost:9092Das Terminal wartet jetzt auf Ihre Eingabe. Schreiben Sie beispielsweise Hi Kafka! und drücken Sie [Enter]. Sie können anschließend weitere Nachrichten eingeben:
My first Kafka message
Kafka uses KRaftJede Zeile wird als eigenes Event in das Topic geschrieben. Mit [Strg] + [C] beenden Sie den Producer.
Schritt 10: Nachrichten mit einem Kafka-Consumer lesen
Öffnen Sie eine zweite SSH-Sitzung bzw. ein zweites Terminalfenster und starten Sie dort einen Consumer:
/opt/kafka/bin/kafka-console-consumer.sh \
    --topic tutorial-topic \
    --from-beginning \
--bootstrap-server localhost:9092Durch --from-beginning liest der Consumer die bereits vorhandenen Events des Topics von Anfang an.
Sie sollten nun beispielsweise folgende Ausgabe sehen:
Hi Kafka!
My first Kafka message
Kafka uses KRaft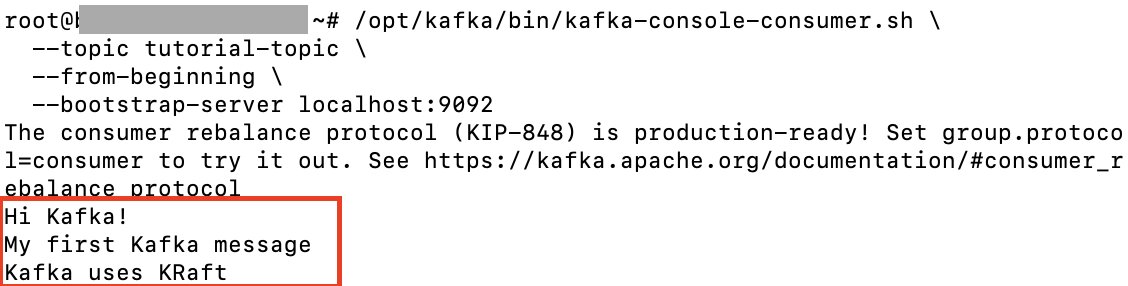
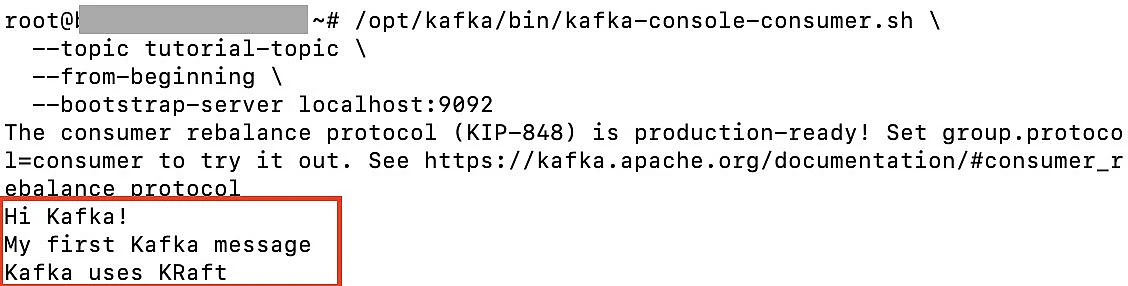
Solange der Consumer läuft, werden auch neue Nachrichten unmittelbar angezeigt. Lassen Sie den Consumer geöffnet und starten Sie in einem zweiten Terminal erneut den Producer. Jede dort eingegebene Nachricht sollte daraufhin direkt im Consumer-Terminal erscheinen.
Damit funktioniert Ihr Kafka-Setup vollständig: Ein Producer schreibt Events in ein Topic, Kafka speichert sie und ein Consumer liest sie wieder aus.
Beenden Sie den Consumer mit [Strg] + [C].
- Neue NVIDIA RTX PRO 6000 Blackwell Hochleistungs-GPUs verfügbar
- Unübertroffene Performance für komplexe KI- und Datenaufgaben
- Gehostet in sicheren und zuverlässigen Rechenzentren
- Flexible Preise – basierend auf Ihrem tatsächlichen Verbrauch
Kafka verwalten: Die wichtigsten systemd-Befehle
Nachdem Kafka als Service eingerichtet wurde, lässt sich der Server mit den üblichen systemd-Befehlen verwalten.
- Kafka starten:
sudo systemctl start kafka - Kafka stoppen:
sudo systemctl stop kafka - Kafka neu starten:
sudo systemctl restart kafka - Status überprüfen:
sudo systemctl status kafka - Automatischen Start aktivieren:
sudo systemctl enable kafka - Automatischen Start deaktivieren:
sudo systemctl disable kafka - Logs anzeigen:
sudo journalctl -u kafka
Vom Single-Node-Setup zum Kafka-Cluster
Das bisherige Kafka-Tutorial richtet einen vollständigen, aber sehr einfachen Kafka-Cluster mit nur einem Node ein. Das eignet sich zum Lernen, Entwickeln und Testen, bietet jedoch keine Ausfallsicherheit. Möchten Sie einen produktiven Kafka-Cluster einrichten, verteilen Sie Kafka auf mehrere Server.
Apache empfiehlt für typische fehlertolerante KRaft-Installationen drei oder fünf Controller. Bei drei Controllern kann ein Controller ausfallen, ohne dass das Controller-Quorum verloren geht. Bei fünf Controllern können zwei Controller ausfallen. Eine Mehrheit der Controller muss jederzeit erreichbar bleiben.
Für kritische Produktivumgebungen sollten Broker- und Controller-Rollen nicht auf demselben Node kombiniert werden. Der kombinierte Modus ist als praktische Lösung für kleine Umgebungen bzw. Entwicklungsumgebungen zu sehen, empfiehlt sich aber nicht für kritische Deployments. Zusätzlich sollten bei einem Multi-Broker-Cluster die Replikationsfaktoren der Topics und der internen Kafka-Topics erhöht werden, damit Daten beim Ausfall eines Brokers weiterhin verfügbar bleiben.
Kafka für den Produktiveinsatz absichern
Das Setup dieses Tutorials wurde bewusst möglichst einfach gehalten. Die Kommunikation zwischen Kafka und den Clients erfolgt über Plaintext. Das bedeutet, dass Kafka in dieser Konfiguration weder Transportverschlüsselung noch eine Client-Authentifizierung verwendet.
Da Kafka in unserem Tutorial ausschließlich an die IP-Adresse 127.0.0.1 gebunden ist, kann der Broker nicht direkt von anderen Rechnern angesprochen werden. Für einen lokalen Test auf einem VPS oder Cloud Server ist das eine sinnvolle Einschränkung.
Sobald Anwendungen von anderen Servern auf Kafka zugreifen sollen, müssen Sie die Netzwerk- und Sicherheitskonfiguration entsprechend erweitern. Stellen Sie einen unverschlüsselten Kafka-Broker nicht einfach über Port 9092 öffentlich ins Internet.
Kafka unterstützt für den Produktivbetrieb unter anderem:
- TLS/SSL für die Verschlüsselung der übertragenen Daten
- SASL für die Authentifizierung von Clients und Brokern
- ACLs zur Steuerung, welche User bzw. Anwendungen Topics lesen, beschreiben oder verändern dürfen
- abgesicherte Firewall-Regeln und private Netzwerke
- getrennte Listener für interne und externe Kommunikation
Bei einem Cloud-Setup empfiehlt es sich zudem, die Kommunikation zwischen den Kafka-Nodes über ein privates Netzwerk abzuwickeln und externen Zugriff ausschließlich für tatsächlich benötigte Clients zuzulassen.
Soll der Kafka-Broker von einem anderen Server erreichbar sein, müssen außerdem listeners und insbesondere advertised.listeners angepasst werden. advertised.listeners ist gerade in Cloud- bzw. IaaS-Umgebungen wichtig, da Kafka Clients darüber mitteilt, unter welcher Adresse sie den Broker tatsächlich erreichen können.
Fazit: Kafka installieren
Mit Kafka 4.x hat sich die Installation der Event-Streaming-Plattform deutlich verändert. Apache ZooKeeper gehört nicht mehr zum Kafka-Stack. Die Verwaltung der Cluster-Metadaten übernimmt stattdessen das integrierte KRaft-System. Für ein einfaches Apache-Kafka-Tutorial genügt ein einzelner Ubuntu-24.04-Server, auf dem Kafka gleichzeitig als Broker und Controller läuft. Nachdem Java installiert, Kafka heruntergeladen und der KRaft-Speicher initialisiert wurde, lässt sich Kafka komfortabel als systemd-Service betreiben.
Reviewers
Sven Ignor
Sven Ignor machte 2008 seine Leidenschaft für TYPO3 zum Beruf und spezialisiert sich seitdem auf individuelle Web-Lösungen. Nach Stationen in Agenturen und auf Unternehmensseite bringt der Quereinsteiger seine über 15-jährige Expertise seit 2022 bei IONOS in den Digital Guide sowie den Startup Guide ein.
Christian Heldmaier
Christian Heldmaier ist ein erfahrener Online-Marketing- und SEO-Spezialist aus Karlsruhe. Seit Juli 2020 ist er als SEO Manager bei IONOS tätig.